Perché una directory di 1.044 aziende non ha bisogno di un CMS: il caso MANYA Madrid
Una directory di oltre mille aziende ha bisogno di un CMS, o bastano file di codice versionati e una build statica?
Di Pietro Fiorillo ·
Indice dell'articolo
Il problema: essere il riferimento locale in un mercato di directory a pagamento
Il mercato era pieno di directory in cui appare in alto chi paga, con recensioni poco affidabili e dati non aggiornati. MANYA Madrid doveva diventare il riferimento locale per trovare aziende affidabili a Madrid, con criteri editoriali visibili invece di posizioni comprate senza etichetta.
Perché il contenuto vive nel codice, non in un CMS
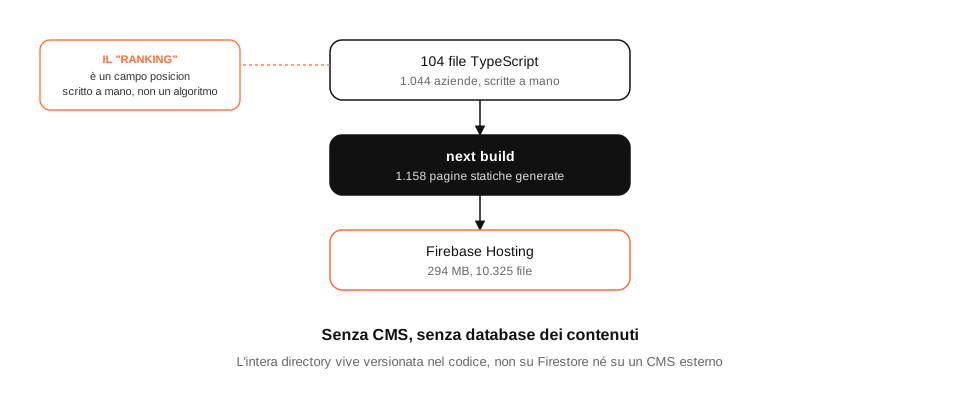
Ogni azienda è un oggetto Empresa definito in TypeScript, dentro uno dei 104 file di dati. Non c'è Sanity, né Contentful, né nessun CMS: il contenuto si modifica direttamente nel codice e si versiona con git.
export interface Empresa {
  slug: string;
  nombre: string;
  sectorSlug: string;
  barrioSlug: string;
  rating: Rating;
  descripcionEditorial: string;
  rangoPrecios: "€" | "€€" | "€€€" | "€€€€";
  premium: boolean;
  asociada?: boolean;
  ultimaVerificacion: string; // fecha ISO de la última verificación
  posicion: number; // 1-10 dentro de sector x barrio
}src/types/index.ts.Il campo posicion è la chiave di tutto il «ranking» della directory: un numero da 1 a 10 all'interno di ogni combinazione di settore e quartiere, scritto a mano da me, non calcolato da nessun algoritmo. La «metodologia a 6 fasi» che descrivo pubblicamente (ricerca, verifica manuale, analisi delle recensioni, valutazione editoriale, ranking, revisione mensile) è esattamente questo: un processo che seguo io, non una pipeline software. Non c'è nessuno scraper, cron o motore di scoring nel repository che la esegua, e preferisco dirlo con questa chiarezza piuttosto che lasciarlo suonare più automatizzato di quanto non sia.
Come funziona il piano premium senza gateway di pagamento
La directory ha un piano gratuito e uno in evidenza, ma non c'è nessuno Stripe né integrazione di pagamento nel codice. La stessa pagina dei piani lo dice: nessun addebito online, il pagamento si formalizza via email dopo aver verificato l'attività.
Contando i flag reali sui 1.044 record: 10 aziende hanno premium: true oggi. Nessuna ha asociada: true, il piano più economico, pensato per formalizzarsi comunque via email.
Come ho validato questa architettura
Ho eseguito npm run build contro il repository reale e ho contato le rotte generate invece di ripetere una cifra a memoria.
const nextConfig: NextConfig = {
  output: "export",
  images: { unoptimized: true },
};next.config.ts.| Metrica | Risultato | Ambiente / evidenza |
|---|---|---|
| Lighthouse Performance (mobile, lab) | 99 / 100 | Lighthouse 13.5.0, throttling simulato |
| LCP (lab) | 1,7 s | Stessa misurazione Lighthouse, non è un dato di campo (CrUX) |
| Tempo di build locale | 27,0 s | next build con Turbopack, Next.js 16.2.2 |
| Pagine statiche generate | 1.158 | 97 pagine di settore, 1.044 di azienda e il resto di rotte fisse |
| Dimensione dell'export | 294 MB in 10.325 file | Cartella /out generata da quella build |
| Commit di sviluppo | 47, da aprile a ottobre 2026 | git log del repository, con attività lo stesso giorno di questo articolo |
È di gran lunga il Lighthouse più alto che ho misurato in tutta questa serie. La mia lettura è che una directory di testo e dati strutturati, senza un carosello di immagini né lettura in tempo reale che blocca il render iniziale, lascia che l'export statico renda al massimo di ciò che può dare: non c'è nulla che compete con l'HTML per il primo paint.
SEO: notificare Google invece di aspettare che scansioni da solo
Il commit più recente del repository, dello stesso giorno in cui scrivo, aggiunge uno script per notificare URL nuovi alla Indexing API di Google, invece di dipendere solo dal fatto che Googlebot le trovi da sola in una directory di oltre mille pagine.
Un sistema non è più affidabile perché suona più automatizzato. È più affidabile quando dici con precisione quale parte è codice e quale è lavoro editoriale.
Il mio ruolo in questo progetto
MANYA Madrid è un progetto proprio all'interno di MANYA Digital: ho progettato l'architettura, costruito il sito e porto avanti la ricerca e la verifica editoriale di ogni azienda elencata.
Cosa farei diversamente: cifre pubblicate che non coincidevano con il codice
Prima di scrivere questo articolo, la pagina del progetto diceva «67 settori» e «oltre 1.050 aziende». Contando direttamente nel codice (e confermandolo con l'output della build), il numero reale è 97 settori e 1.044 aziende. Ho già corretto quelle cifre nella pagina del progetto; le lascio registrate qui per quello che erano: un dato non aggiornato, non un'esagerazione deliberata, ma comunque un dato reale non aggiornato.
Cosa proverei dopo
Valuterei a che punto l'approccio «dati come codice» smette di essere comodo, probabilmente quando più di una persona dovrà modificare contemporaneamente, e automatizzerei un avviso semplice basato sul campo ultimaVerificacion per sapere quali schede sono da più tempo senza revisione prima che qualcuno debba cercarlo a mano.
Fonti
Domande frequenti
La metodologia a 6 fasi è un sistema automatizzato?
No. È un processo editoriale: ricerca, verifica manuale, analisi delle recensioni, valutazione editoriale, ranking e revisione mensile. Non ho trovato nessuno scraper, cron o motore di scoring nel codice che la esegua. Le 6 fasi descrivono come lavoro io, non una pipeline software.
Come si decide il ranking di ogni azienda?
Con un campo posicion (da 1 a 10 all'interno di ogni settore e quartiere) scritto a mano nel file dati di ogni azienda. Non c'è un algoritmo di scoring: la posizione è una decisione editoriale che carico direttamente nel codice.
C'è un CMS dietro la directory?
No. Le 1.044 aziende vivono in 104 file TypeScript versionati nel repository, non su Firestore né su un CMS esterno. Firestore si usa solo per i moduli di contatto e le segnalazioni di modifica.
Perché il Lighthouse di questo progetto è così alto rispetto ad altri?
Probabilmente perché è una directory di testo e dati strutturati, senza un carosello di immagini pesante né una lettura in tempo reale che blocca il rendering iniziale, a differenza di un catalogo prodotti. L'export statico rende meglio quando c'è meno contenuto multimediale da caricare.
Quanto costa mantenere una directory così?
L'hosting è minimo perché è un export statico. Il costo reale è il tempo editoriale: ricercare, verificare e mantenere aggiornate a mano 1.044 schede aziendali, senza un CMS che automatizzi il caricamento dei dati.