Come ho costruito un negozio con catalogo in tempo reale e rebuild automatico: il caso Los Luises
Si possono avere dati in tempo reale (prezzo, stock) su un sito generato staticamente, senza perdere la velocità dell'export statico né dipendere da una persona per ripubblicare?
Di Pietro Fiorillo ·
Indice dell'articolo
Il problema: un catalogo che cambia ogni giorno, in un sito generato una volta sola
Los Luises è un laboratorio di sublimazione e stampa con oltre 26 anni di attività. Il suo catalogo cambia spesso: prezzi, offerte, stock e nuovi prodotti. Il sito, invece, è un export statico di Next.js: HTML generato una volta in build time, senza server dietro. Se ogni modifica di prezzo richiedesse una build completa, il catalogo non sarebbe mai aggiornato.
Perché ho separato la lettura in tempo reale dal rebuild
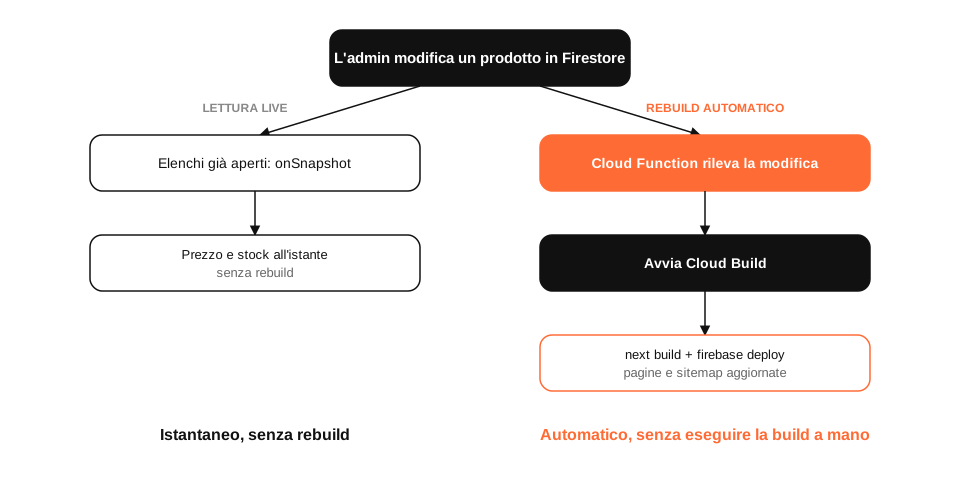
Invece di forzare tutto su un unico percorso, ho diviso il problema in due. Per i dati che cambiano spesso (prezzo, stock, offerte), il browser ascolta Firestore direttamente. Per le modifiche che richiedono una pagina nuova o toccano la sitemap (un prodotto nuovo, per esempio), il sito viene rigenerato per intero.
L'hook che fa la lettura in tempo reale è semplice: si iscrive alla collezione products con onSnapshot e aggiorna lo stato ogni volta che qualcosa cambia in Firestore, senza che l'utente ricarichi la pagina.
export function useProducts() {
  const [products, setProducts] = useState<Product[]>([]);
  const [loading, setLoading] = useState(true);
  const [error, setError] = useState<Error | null>(null);

  useEffect(() => {
    const unsubscribe = onSnapshot(
      collection(db, "products"),
      (snapshot) => {
        setProducts(snapshot.docs.map((doc) => doc.data() as Product));
        setLoading(false);
      },
      (err) => {
        setError(err);
        setLoading(false);
      }
    );
    return unsubscribe;
  }, []);

  return { products, loading, error };
}lib/useProducts.ts nel repository del progetto, ottobre 2026.Come si avvia il rebuild da solo
L'altra metà del sistema è una Cloud Function che ascolta qualsiasi scrittura su products/{productId}. Quando rileva una modifica, chiama direttamente l'API di Cloud Build per avviare una build nuova, senza che una persona debba eseguire nulla.
exports.rebuildOnProductChange = onDocumentWritten(
  { document: "products/{productId}", region: "us-central1", memory: "256MiB" },
  async (event) => {
    const auth = new GoogleAuth({
      scopes: ["https://www.googleapis.com/auth/cloud-platform"],
    });
    const client = await auth.getClient();
    const projectId = await auth.getProjectId();

    const body = {
      source: { storageSource: { bucket, object } },
      steps: buildSteps(),
      timeout: "1200s",
    };

    await client.request({
      url: `https://cloudbuild.googleapis.com/v1/projects/${projectId}/builds`,
      method: "POST",
      data: body,
    });
  }
);

// Debe reflejar los mismos steps que cloudbuild.yaml en la raíz del repo.
// Si cambiás cloudbuild.yaml, actualizá esto también.functions/index.js. Il commento su cloudbuild.yaml è nel file originale, non l'ho aggiunto io.Quel commento nel codice è, letteralmente, una nota che ho lasciato a me stesso: i passi della build (buildSteps()) devono coincidere con quelli di cloudbuild.yaml nella root del repo, e se ne cambio uno devo ricordarmi di cambiare anche l'altro a mano. Ci torno nella sezione sul debito tecnico.
Come ho validato questa architettura
Ho eseguito davvero npm run build contro il repository (Next.js 16.2.12, Turbopack, con il .env.local reale del progetto) e ho misurato il risultato invece di descriverlo a memoria. La build è terminata in 18,8 secondi e ha generato 74 rotte statiche, incluse 54 pagine prodotto (38 personalizzati e 16 di stock) e un sitemap.xml con 62 URL, che coincide con quanto restituisce il sito in produzione.
const nextConfig: NextConfig = {
  output: "export",
  images: {
    unoptimized: true,
  },
};next.config.ts. Come in altri progetti, images.unoptimized è obbligatorio insieme all'export statico.Risultati misurabili
Ho misurato quanto segue il 18 ottobre 2026, con Lighthouse (dati di laboratorio, throttling simulato) contro il sito in produzione, e con una build reale in locale.
| Metrica | Risultato | Ambiente / evidenza |
|---|---|---|
| Lighthouse Performance (mobile, lab) | 61 / 100 | Lighthouse 13.5.0, throttling simulato |
| LCP (lab) | 18,3 s | Stessa misurazione Lighthouse, non è un dato di campo (CrUX) |
| Tempo di build locale | 18,8 s | next build, Next.js 16.2.12, Turbopack |
| Dimensione dell'export statico | 24 MB in 781 file | Cartella /out generata da quella build |
| Rotte statiche generate | 74 (54 pagine prodotto) | Log della build |
| URL nella sitemap | 62 | sitemap.xml generato dalla build e confermato in produzione |
L'LCP di 18,3 secondi è il più alto tra tutti i progetti che ho misurato per questa serie. La mia ipotesi, senza aver profilato a fondo il browser, è che si sommino due costi: images.unoptimized: true (come in altri progetti con export statico) e il fatto che la lista prodotti dipenda dal primo snapshot di Firestore ricevuto da onSnapshot prima di poter disegnare qualcosa. È un'ipotesi ragionevole a partire dal codice, non una causa confermata con il profiling.
Sicurezza a livelli: cosa permettono queste regole e cosa no
La collezione products si può leggere senza autenticazione (sono dati di catalogo, non sensibili) ma si può scrivere solo con una sessione autenticata. Sono le regole reali del progetto, senza riassumere né addolcire.
rules_version = '2';
service cloud.firestore {
  match /databases/{database}/documents {
    match /products/{productId} {
      allow read: if true;
      allow write: if request.auth != null;
    }
  }
}firestore.rules nel repository del progetto.Questo protegge da scritture anonime sul database. Non dice nulla sulla sicurezza del pannello /admin in sé (login, gestione della sessione) né su altre parti del sistema: è un pezzo della sicurezza, non tutta la sicurezza.
Separare ciò che cambia continuamente da ciò che richiede una pagina nuova non è un'ottimizzazione, è la domanda giusta prima di scegliere l'architettura.
Il mio ruolo in questo progetto
Il mio ruolo in Los Luises Sublimación ha incluso il design completo dell'architettura, lo sviluppo full-stack (frontend, pannello admin e Cloud Function), l'infrastruttura su Firebase e Google Cloud, e la SEO tecnica, come parte del mio lavoro in MANYA Digital.
Cosa farei diversamente: un avvertimento che ho trovato nel mio stesso codice
Rivedendo il repository per questo articolo ho trovato due cose che non ricordavo con precisione. La prima: i passi della pipeline di build sono scritti due volte, una nella Cloud Function e una in cloudbuild.yaml, e il codice stesso ha un commento che chiede di aggiornarli insieme. È esattamente il tipo di duplicazione che si disallinea nel tempo se nessuno se ne accorge.
La seconda: il runtime della Cloud Function è fissato a Node 20, mentre i passi di Cloud Build girano su immagini Node 22. Non rompe nulla oggi, ma sono due versioni di Node che convivono nella stessa pipeline senza che questo sia documentato da nessuna parte fino a questo articolo.
Nessuno dei due punti influisce sul sito in produzione in questo momento. Li lascio documentati perché sono il tipo di dettaglio che vale la pena conoscere prima di toccare la pipeline, non dopo che qualcosa si rompe per un aggiornamento fatto in un solo posto.
Cosa proverei dopo
Unificherei la definizione della pipeline in un solo file (facendo leggere alla Cloud Function cloudbuild.yaml invece di duplicarne i passi in JavaScript), allineerei la versione di Node tra la funzione e le immagini di Cloud Build, e ottimizzerei le immagini del catalogo per abbassare l'LCP misurato di 18,3 secondi, probabilmente la modifica con l'impatto reale maggiore delle tre.
Fino ad allora, il sistema mantiene quello che promette: prezzo e stock all'istante, pagine nuove senza che nessuno esegua un deploy a mano, e un avvertimento nel codice che, ora sì, resta scritto in un posto dove non andrà perso.
Fonti
Domande frequenti
Perché non usare semplicemente l'ISR di Next.js invece di Firestore in tempo reale?
Perché il sito è esportato come statico (output: export), e quella modalità non supporta l'ISR: nessun valore di revalidate ha un effetto reale in produzione. La lettura in tempo reale con onSnapshot risolve il problema in un altro modo, nel browser, senza dipendere da un server Next.
Cosa succede se Cloud Build fallisce nel ricostruire il sito?
Il sito pubblico continua a funzionare con l'ultima versione pubblicata; non si ferma. Quello che non succede è che le pagine nuove, la sitemap o i dati strutturati si aggiornino finché una build successiva non va a buon fine. Non ho verificato un avviso automatico di build fallita in questa uscita.
È sicuro che chiunque possa leggere la collezione di prodotti?
Le regole di Firestore permettono la lettura pubblica solo della collezione products e richiedono l'autenticazione per scrivere. È lo stesso modello di una API pubblica di catalogo: i dati prodotto non sono sensibili, ma nessuno può modificarli senza aver fatto login.
Perché due sistemi (lettura live e rebuild) invece di uno solo?
Risolvono problemi diversi. onSnapshot aggiorna prezzo e stock all'istante su una pagina già caricata, ma non crea pagine nuove né aggiorna la sitemap. Il rebuild fa questo, ma richiede minuti. Insieme coprono sia l'aggiornamento immediato sia la SEO statica.
Quanto tempo ci vuole per vedere una modifica reale?
Dipende da cosa cambia. Un prezzo o lo stato dello stock si vede all'istante in qualsiasi scheda aperta. Un prodotto nuovo richiede che la build finisca (ho misurato 18,8 secondi in locale, senza contare il deploy) prima di avere una propria pagina e comparire nella sitemap.
Quanto costa mantenere un'architettura così?
Il costo dipende dall'uso di Firestore, Cloud Functions, Cloud Build e Firebase Hosting, che hanno livelli gratuiti ampi per un catalogo di queste dimensioni. Non c'è un server Node proprio da pagare né da mantenere.