Come ho trovato un <head> contaminato da otto <title> e una home che serviva un'altra pagina: il caso Vicent Florencia
Un sito può sembrare perfetto navigandolo e, allo stesso tempo, servire un HTML rotto a chiunque non esegua il suo JavaScript?
Di Pietro Fiorillo ·
Indice dell'articolo
Il problema documentato: un portfolio personale che doveva apparire professionale fin dal primo clic
Vicent è ballerino e insegnante di balletto classico e danza contemporanea a Madrid. Aveva bisogno di un sito che trasmettesse sensibilità estetica senza perdere chiarezza commerciale, con una sezione «Chi sono», servizi, galleria e un canale di contatto diretto per prenotare lezioni.
Perché ho deciso di chiedere al sito esattamente ciò che gli chiede un crawler
Non ho accesso al repository di questo progetto. Invece di limitarmi a descrivere l'architettura documentata, ho usato curl per richiedere la home esattamente come farebbe un motore di ricerca: senza eseguire JavaScript, leggendo solo l'HTML che il server restituisce all'inizio.
Cosa ho trovato: un head con otto titoli e un body che non corrisponde
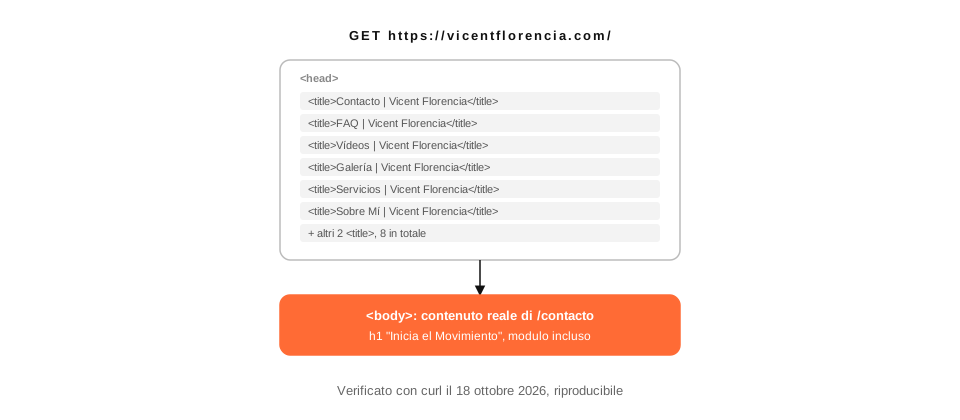
L'<head> di https://vicentflorencia.com/ contiene otto tag <title> consecutivi: Contatti, FAQ, Video, Galleria, Servizi e Lezioni, Chi Sono, il titolo completo della home, e un ottavo generico. Non è un singolo tag con un testo lungo: sono otto elementi <title> distinti, uno dopo l'altro.
Ancora più sorprendente: il <body> che segue quell'head non è quello della home. È, letteralmente, il contenuto della pagina /contacto: l'intestazione «Inicia el Movimiento», il blocco contatti con WhatsApp e Instagram, e il modulo completo con i suoi campi nome, email e servizio di interesse.
Ho ripetuto la richiesta in un momento diverso, per sicurezza che non fosse uno stato transitorio, e ho ottenuto esattamente lo stesso risultato entrambe le volte. Non è uno sfarfallio passeggero: è ciò che il server risponde in modo coerente.
Perché questo non si nota navigando il sito
È una SPA: non appena il JavaScript si carica nel browser, il router prende il controllo e mostra la pagina corretta in base all'URL, inclusa la vera home. Per questo una persona che naviga il sito non vede mai questo problema. Chi lo vede è qualsiasi sistema che legga l'HTML prima di eseguire JavaScript, che è esattamente il caso di molti crawler e dell'anteprima che un social crea condividendo il link.
Risultati misurabili
| Metrica | Risultato | Ambiente / evidenza |
|---|---|---|
| Lighthouse Performance (mobile, lab) | 91 / 100 | Lighthouse 13.5.0, throttling simulato |
| LCP (lab) | 3,3 s | Stessa misurazione Lighthouse, non è un dato di campo (CrUX) |
| Tag <title> nella home | 8 | Confermato due volte con curl in momenti diversi |
| URL nella sitemap | 12 | sitemap.xml pubblica, confermata con curl |
Un sito che appare perfetto non è lo stesso di un sito che funziona bene. Il primo lo giudica una persona che naviga; il secondo, chiunque legga l'HTML così come arriva.
Il mio ruolo in questo progetto
Il mio ruolo in Vicent Florencia ha incluso il design del personal brand e lo sviluppo del sito, come parte del mio lavoro in MANYA Digital.
Cosa farei diversamente: un bug di produzione impossibile da vedere senza controllare l'HTML grezzo
Questo è, direttamente, un difetto reale sul sito in produzione, non un'imprecisione in come l'ho documentato. Non ho accesso al repository in questo momento per correggerlo, ma lo lascio documentato con la massima precisione possibile: la causa più probabile, da ciò che posso osservare dall'esterno, è uno script di generazione dell'HTML statico che non resetta l'<head> tra una rotta e la successiva, e che a un certo punto ha salvato il body sbagliato per la home.
Cosa proverei dopo
Se avessi accesso al repository, il mio primo passo sarebbe rivedere lo script che genera l'HTML statico di ogni rotta, confermare che resetta il documento prima di elaborare la pagina successiva, e aggiungere una verifica automatica semplice (contare i tag <title> di ogni rotta pubblicata) perché un problema del genere si individui in minuti e non con una revisione manuale come questa.
Fonti
Domande frequenti
Cosa significa avere otto tag <title> in una sola pagina?
Che l'head del documento ha accumulato il title di ciascuna delle otto pagine del sito, invece di avere solo quello corrispondente a quell'URL. È un sintomo di un processo di generazione HTML che non resetta lo stato tra una pagina e l'altra.
Questo influisce su ciò che vede una persona che naviga il sito?
Una volta che il JavaScript del sito si carica nel browser, l'applicazione prende il controllo e mostra la pagina corretta in base alla rotta. Il problema è specifico dell'HTML servito prima che il JavaScript giri, che è esattamente ciò che vedono i crawler e ciò che determina il title che Google può mostrare nei risultati.
Perché il body servito sulla home è quello della pagina contatti?
Non ho accesso al repository per confermare la causa esatta, ma il pattern è coerente con uno script di prerendering che visita ogni rotta e salva l'HTML risultante, e a un certo punto il file della home è finito sovrascritto con il contenuto dell'ultima rotta visitata invece di quella corrispondente.
È un caso isolato o l'hai visto in altri progetti?
In questa stessa serie ho documentato un problema diverso di prerendering (assente, non corrotto) in un altro progetto, e ho confermato che funziona correttamente in un terzo. Ogni caso ha una causa diversa; ciò che hanno in comune è che nessuno si nota navigando il sito a occhio.
Come hai verificato questo senza accesso al codice?
Ho richiesto la home con curl due volte, in momenti diversi, e ho ottenuto lo stesso risultato entrambe le volte: otto <title>, un body con il modulo di contatto. Non è un errore del mio strumento, è ciò che il server risponde in modo coerente.
Come si risolverebbe questo problema?
Rivedendo lo script di generazione dell'HTML statico per confermare che resetta l'head (e salva il body corretto) prima di elaborare ogni nuova rotta. Senza accesso al repository, non posso dire altro.