Come ho costruito il sito di uno studio legale con 37 landing (e tre tentativi prima di azzeccare l'email)
Come si costruisce un sito ad alta conversione per uno studio legale quando il primo, il secondo e perfino il terzo tentativo di risolvere qualcosa di semplice come un modulo di contatto non funzionano come previsto?
Di Pietro Fiorillo ·
Indice dell'articolo
Il problema: generare consulenze per uno studio che dipendeva solo dai passaparola
Lo studio aveva esperienza reale nella gestione di richieste di risarcimento per incidenti stradali e sinistri assicurativi, ma dipendeva interamente da raccomandazioni passaparola. Senza presenza digitale né acquisizione attiva, la crescita aveva un tetto basso.
Perché 37 landing e non una sola pagina servizi
Il sito ha 37 cartelle di rotta, in gran parte landing per tipo di incidente: scontri, investimenti, sinistri con fuga, infortuni sul lavoro in itinere e 19 tipi diversi di risarcimento (amputazione, paraplegia, tetraplegia, colpo di frusta, tra gli altri). Ognuna compete per una ricerca specifica invece di competere tutte sugli stessi termini generici.
A questo si aggiunge un blog di 6 articoli in 4 categorie (Guide, Legislazione, Lesioni, Tipi di Incidente) per intercettare traffico di chi non sa ancora di avere un caso.
I tre tentativi di risolvere qualcosa di semplice come un modulo di contatto
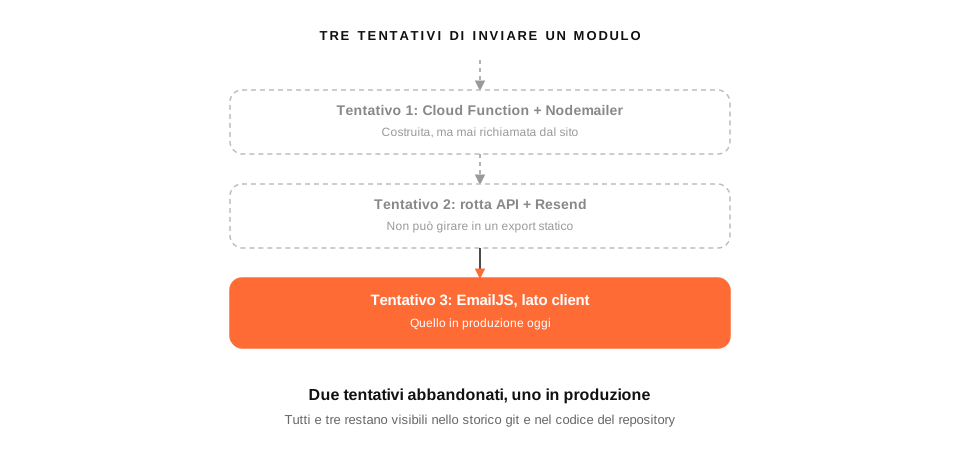
Questa è la parte che di solito non si racconta in un caso di successo, ed è quella che spiega meglio come si costruisce davvero il software. Il modulo di contatto è passato per tre implementazioni diverse prima di arrivare a quella che funziona oggi.
Il primo tentativo è stata una Cloud Function che riceveva il modulo e inviava l'email con Nodemailer, salvando anche il lead in una collezione Firestore. Funziona come funzione isolata, ma non viene mai richiamata dal frontend in produzione: è rimasta costruita e scollegata.
const db = admin.firestore();
const docRef = await db.collection("leads").add({
  nombre, email,
  telefono: telefono || "",
  asunto: asunto || "",
  mensaje,
  createdAt: admin.firestore.FieldValue.serverTimestamp(),
  ip: req.ip || "",
  userAgent: req.get("user-agent") || "",
});functions/index.js. Resta nel repository, ma nulla del sito la invoca.Il secondo tentativo è stata una rotta API di Next.js (/api/send-email) con Resend, con template HTML bilingue completi. Tecnicamente più curata della prima, ma con un problema di fondo: è una rotta dinamica, e Next.js non include rotte che dipendono dalla request quando il sito viene esportato come statico. La build la segna come rotta server (ƒ), e quel segno è, nei fatti, una condanna a morte per un sito su Firebase Hosting.
Il terzo tentativo, quello in produzione, invia il modulo direttamente dal browser con EmailJS, in due chiamate a due template diversi.
await emailjs.send(SERVICE_ID, 'template_9mu4p5c', {
  nombre, email, telefono, asunto, mensaje,
  cc_email: 'lexxionaabogados@gmail.com',
}, PUBLIC_KEY);
await emailjs.send(SERVICE_ID, 'template_zvnj7ov', {
  nombre, email, telefono, asunto, mensaje,
}, PUBLIC_KEY);
window.location.href = '/gracias';src/app/contacto/page.js. Questo è ciò che gira in produzione oggi.Nessuna delle tre decisioni è stata arbitraria al momento. Ognuna risolveva qualcosa che la precedente non risolveva bene, fino ad arrivarne a una che gira in modo affidabile entro i vincoli reali dell'export statico.
Come ho validato questa architettura
Ho eseguito npm run build contro il repository reale (Next.js 16.1.6, Turbopack) e ho confermato il risultato invece di descriverlo a memoria.
const nextConfig = {
  output: 'export',
  trailingSlash: true,
  images: { unoptimized: true },
};next.config.mjs.Risultati misurabili
| Metrica | Risultato | Ambiente / evidenza |
|---|---|---|
| Lighthouse Performance (mobile, lab) | 71 / 100 | Lighthouse 13.5.0, throttling simulato |
| LCP (lab) | 6,9 s | Stessa misurazione Lighthouse, non è un dato di campo (CrUX) |
| Tempo di build locale | 7,26 s | next build con Turbopack, Next.js 16.1.6 |
| Dimensione dell'export statico | 11 MB in 720 file | Cartella /out generata da quella build |
| Rotte generate | 79 (77 statiche, 2 SSG) | Log della build. La rotta dinamica di Resend non è inclusa |
| Commit di sviluppo | 91, da luglio a ottobre 2026 | git log del repository |
SEO e GEO: cosa dice il robots.txt e cosa controlla davvero
Il robots.txt reale del sito abilita esplicitamente GPTBot, ClaudeBot, PerplexityBot, Google-Extended e altri, e blocca scraper SEO aggressivi. Il file stesso etichetta Google-Extended come «Google Gemini & AI Overviews», ma secondo la documentazione di Google quel token non controlla l'inclusione in Google Search né in AI Overviews: decide solo se il contenuto può essere usato per addestrare modelli e fondare risposte. Vale la pena non ripetere quell'associazione come se fosse esatta.
L'architettura giusta non è quella progettata bene sulla carta, è quella che continua a funzionare dopo il secondo tentativo fallito.
Il mio ruolo in questo progetto
Il mio ruolo in Lexiona Abogados ha incluso lo sviluppo web completo, le campagne Google e Meta Ads, e l'integrazione del tracciamento delle conversioni, come parte del mio lavoro in MANYA Digital.
Cosa farei diversamente: codice morto che dovrebbe smettere di esserlo
La Cloud Function con Nodemailer e la rotta con Resend non rompono nulla oggi perché nessuno le richiama. Ma restano lì, come due percorsi che qualcuno potrebbe imboccare per errore pensando che siano attivi. Non c'è nessuna nota nel repository che dica quale dei tre meccanismi sia quello reale.
Non ho nemmeno verificato se il modulo in produzione abbia una protezione antispam. EmailJS non lo risolve da solo, ed è il tipo di domanda che vale la pena rispondere prima che diventi un problema.
Cosa proverei dopo
Documenterei nel repository stesso quale dei tre meccanismi di invio è attivo, perché nessuno perda tempo con gli altri due, e valuterei se convenga eliminare direttamente il codice morto invece di lasciarlo come possibilità confusa. Rivedrei anche se il modulo necessita di rate limiting o un captcha, cosa che non sono riuscito a verificare in questa uscita.
Fonti
Domande frequenti
Perché il sito ha finito per inviare il modulo con EmailJS invece di un backend proprio?
Perché il sito è un export statico di Next.js e non può eseguire rotte server in produzione. Prima di arrivare a EmailJS ho provato una Cloud Function con Nodemailer e una rotta API con Resend; nessuna delle due è arrivata in produzione così com'era pensata.
Cosa è successo con la Cloud Function e la rotta con Resend?
Entrambe restano nel repository, ma non vengono usate. La Cloud Function scrive lead su Firestore e non viene mai chiamata dal sito. La rotta con Resend è una API route dinamica, e Next.js non la include in un export statico: non può essere eseguita in produzione così com'è.
È sicuro inviare l'email direttamente dal browser con EmailJS?
La chiave pubblica di EmailJS è pensata per essere esposta lato client, come una API key pubblica. Il rischio reale è l'abuso del modulo (spam), non la fuga di credenziali. Non ho verificato se il progetto ha rate limiting o captcha in questa uscita.
Come misura lo studio se le campagne funzionano, se non c'è un CRM?
Con i dati delle piattaforme pubblicitarie stesse: la Conversions API di Meta riceve eventi di conversione da una Cloud Function, e PostHog registra il comportamento sul sito. Nessuno dei due sostituisce un CRM con monitoraggio dei casi.
Perché 37 landing invece di una sola pagina servizi?
Perché ogni tipo di incidente (scontro, investimento, sinistro con fuga, 19 tipi di risarcimento, tra gli altri) è una ricerca diversa con un'intenzione diversa. Una sola pagina generica compete peggio su ogni termine specifico rispetto a una landing dedicata.
Quanto costa mantenere un sito così?
L'hosting è minimo perché è un export statico su Firebase Hosting. Il costo reale sta nelle campagne Google e Meta Ads, e nel tempo di mantenere aggiornati i contenuti (37 landing, 6 articoli del blog).