Come ho costruito un sito aziendale headless con Sanity e Next.js: il caso QBO Imagen
Si può dare a un cliente una reale autonomia per modificare i contenuti, senza un server proprio da mantenere, senza perdere velocità né visibilità su Google e sui motori di ricerca con IA?
Di Pietro Fiorillo ·
Indice dell'articolo
Il problema: uno studio che non poteva dipendere da uno sviluppatore per ogni modifica
QBO Imagen è uno studio di design grafico, cartellonistica e marketing applicato a Neuquén, in Argentina. Il team aveva bisogno di aggiornare da solo portfolio, servizi, testimonianze e dati di contatto, senza scrivermi ogni volta che arrivava un nuovo lavoro o cambiava un numero di telefono.
A questo si aggiungevano due requisiti tecnici: il sito doveva caricarsi velocemente in tutto il paese, perché buona parte dei clienti di QBO sono remoti, e doveva competere per la visibilità non solo su Google ma anche sui motori di ricerca con IA che hanno guadagnato peso nel corso del 2026.
Perché ho scelto Sanity e Next.js invece di un CMS tradizionale
Un CMS tradizionale (WordPress, per esempio) mescola contenuto, logica di presentazione e server nella stessa installazione. Funziona, ma ogni aggiornamento, ogni plugin e ogni tema sono una superficie d'attacco e un punto di fallimento in più da mantenere.
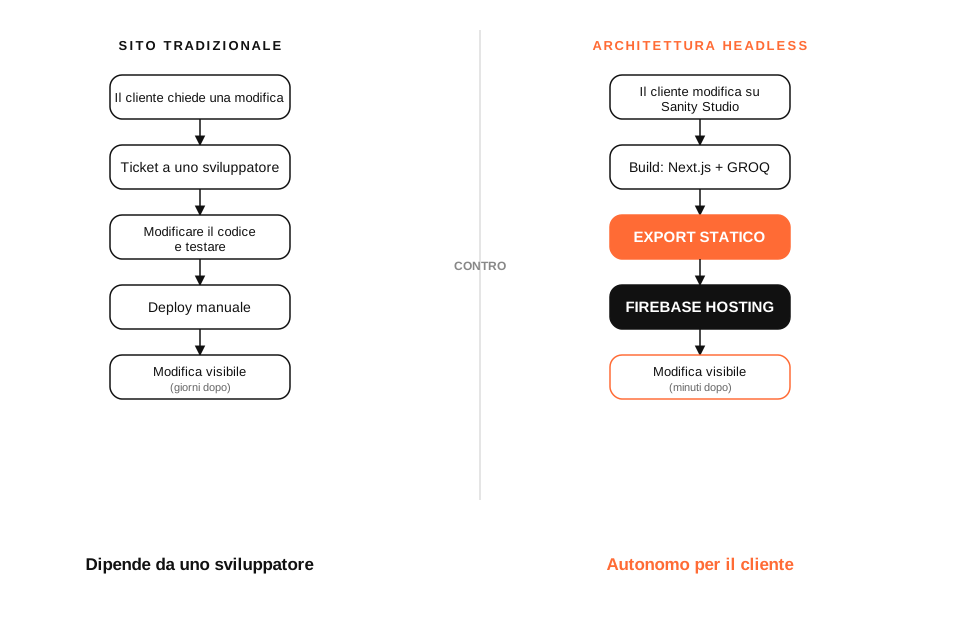
Ho scelto di separare le due cose: il contenuto vive in Sanity Studio, un editor visuale a cui QBO accede dal browser, e il codice vive in un repository Next.js che mantengo io. Next.js consuma il contenuto di Sanity in build time, via GROQ, il linguaggio di query di Sanity, e genera il sito come file HTML, CSS e JS statici con output: export. Questi file sono quelli che finiscono su Firebase Hosting.
La conseguenza più importante: in produzione non c'è nessun server Node in esecuzione. Il sito che vede il visitatore è HTML servito da una CDN. Non c'è un database da attaccare, non c'è un runtime da patchare, non c'è cold start.
Come funziona in pratica: dallo Studio a Firebase Hosting
Il flusso completo ha tre momenti distinti. Il cliente modifica il contenuto su Sanity Studio quando vuole. La build parte quando qualcuno (per ora, io) esegue npm run build: in quel momento Next.js fa il fetch di sei query GROQ in parallelo (dati del sito, servizi, portfolio, statistiche, testimonianze e clienti) e costruisce ogni pagina con quei dati. Il deploy carica la cartella /out risultante su Firebase Hosting con firebase deploy.
Tra una build e la successiva, il sito pubblico non interroga più Sanity. Se QBO carica un nuovo lavoro nel portfolio a mezzogiorno, quel lavoro non compare sul sito finché qualcuno non esegue la build successiva. È la parte meno automatica del sistema, e la documento senza addolcirla nella sezione sul debito tecnico più sotto.
| Livello | Cosa fa | Quando si aggiorna |
|---|---|---|
| Sanity Studio | Il cliente modifica portfolio, servizi, testimonianze e dati di contatto | In qualsiasi momento, dal browser |
| Build (Next.js + GROQ) | Legge il contenuto da Sanity e genera HTML, CSS e JS statici | Quando qualcuno esegue npm run build |
| Firebase Hosting | Serve i file statici da una CDN globale | A ogni firebase deploy |
Come ho validato l'architettura di QBO Imagen
Per scrivere questo articolo non mi sono limitato a descrivere l'architettura a memoria: ho diviso la revisione in quattro aree e ho lasciato una traccia verificabile di ciascuna. Questo corrisponde allo stato del progetto documentato a ottobre 2026; i miglioramenti in sospeso sono nell'ultima sezione.
Generazione statica. Ho eseguito next build in locale (Next.js 16.2.9 con Turbopack, Node 24.11.1) e ho ispezionato la cartella /out risultante per verificare quale contenuto finisce nell'HTML prima del deploy.
Gestione dei contenuti. Ho rivisto come Sanity Studio modella servizi, portfolio, testimonianze e dati di contatto, e ho letto le query GROQ reali che li recuperano in build time, in sanity/lib/queries.ts.
Tolleranza ai guasti. Ho letto l'implementazione reale di safeFetch e dei suoi fallback. Fa esattamente quello che dico che fa, né più né meno: evita che un errore nell'interrogare Sanity rompa la build, ma non protegge da altri errori di compilazione o di deploy.
SEO tecnica. Ho rivisto i metadati, i dati strutturati, la sitemap e il robots.txt reali del repository. Il fatto che questi elementi esistano non dimostra da solo che il sito sia indicizzato né che compaia nelle risposte dei sistemi di IA: non l'ho misurato in questa uscita.
async function safeFetch<T>(query: string, fallback: T): Promise<T> {
  if (!isSanityConfigured) return fallback;
  try {
    return await client.fetch(query, {}, { next: { revalidate: 60 } });
  } catch {
    return fallback;
  }
}sanity/lib/queries.ts nel repository del progetto, ottobre 2026.const nextConfig: NextConfig = {
...(process.env.NODE_ENV === "production" ? { output: "export" as const } : {}),
images: {
unoptimized: true,
// remotePatterns: cdn.sanity.io, img.youtube.com
},
};next.config.ts. L'export statico si attiva solo in produzione; in sviluppo il sito gira con il normale server Next.js.Risultati misurabili: cosa misura e cosa no
Ho misurato quanto segue il 18 ottobre 2026, contro l'hosting di produzione su Firebase. Sono dati di laboratorio (Lighthouse, con throttling simulato), non dati di campo di utenti reali (CrUX), e lo chiarisco perché è una distinzione che quasi mai viene spiegata.
| Metrica | Risultato | Ambiente / evidenza |
|---|---|---|
| Lighthouse Performance (mobile, lab) | 64 / 100 | Lighthouse 13.5.0, throttling simulato |
| LCP (lab) | 9,9 s | Stessa misurazione Lighthouse, non è un dato di campo (CrUX) |
| CLS (lab) | 0 | Stessa misurazione Lighthouse |
| Tempo di build locale | 28,1 s | next build con Turbopack, Next.js 16.2.9, Node 24.11.1 |
| Dimensione dell'export statico | 33 MB in 205 file | Cartella /out generata da quella build |
| URL indicizzate su Google | Non misurato in questa uscita | Richiede accesso a Search Console, che non ho usato per questo articolo |
| Tempo da build a sito pubblicato | Non misurato in questa uscita | Ho misurato la build locale; il passaggio firebase deploy non è stato cronometrato qui |
Un LCP di 9,9 secondi è lento, anche per un sito statico. La causa più probabile sta nel codice stesso: next.config.ts impone images.unoptimized: true, un requisito dell'export statico, quindi l'hero con carosello e le immagini del portfolio non passano da nessuna pipeline di ottimizzazione immagini. È un miglioramento in sospeso reale, non un dettaglio minore, e lo aggiungo ai prossimi passi più sotto.
Il pattern fallback first: cosa protegge e cosa non protegge
Se Sanity non risponde durante una build, o se manca una variabile d'ambiente, il pattern fallback first evita che quel problema specifico rompa la generazione del sito. Ogni componente che dipende da contenuto esterno (l'hero, il portfolio, le testimonianze, il footer) ha un proprio contenuto di riserva scritto a mano dentro il componente.
La funzione che fa questo lavoro, safeFetch, segue sempre la stessa regola: se Sanity non è configurato, restituisce il fallback senza tentare la chiamata di rete; se la chiamata fallisce per qualsiasi motivo, cattura l'errore in silenzio e restituisce lo stesso fallback.
Questo protegge da un problema specifico: che Sanity non risponda. Non protegge da un errore di TypeScript, una dipendenza rotta o un guasto del processo di build stesso. Il pattern fallback first è una rete di sicurezza circoscritta, non una garanzia che il sito non si rompa mai.
La SEO non basta: cosa controlla (e cosa non controlla) il robots.txt
Il sito investe nella visibilità verso due tipi di crawler diversi. Per i motori di ricerca tradizionali, ci sono dati strutturati Organization, WebSite e LocalBusiness, una sitemap con priorità per tipo di pagina e metadati dinamici per ogni landing di servizio.
Per i crawler di IA, il robots.txt abilita esplicitamente GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Google-Extended, Applebot-Extended e altri, seguendo il protocollo di esclusione robot, bloccando allo stesso tempo scraper SEO aggressivi come AhrefsBot o SemrushBot.
Vale la pena essere precisi su uno di questi token: Google-Extended non è Googlebot e non decide cosa viene indicizzato su Google Search. Secondo la documentazione di Google, controlla se il contenuto scansionato può essere usato per addestrare i modelli Gemini e per fondare le risposte con l'indice di Search (grounding); non influisce sull'inclusione del sito in Google Search né agisce come segnale di ranking. Abilitarlo non equivale a migliorare la comparsa in AI Overviews, e non ho fatto nessuna misurazione a sostegno di quel legame.
L'autonomia di contenuto non è una funzione che si aggiunge alla fine, è una decisione di architettura che si prende all'inizio.
Il mio ruolo in questo progetto
Per essere chiaro su cosa intendo quando dico «ho costruito»: il mio ruolo in QBO Imagen ha incluso il design dell'architettura headless, l'integrazione di Sanity CMS, lo sviluppo del frontend con Next.js, la configurazione dell'export statico, il deploy su Firebase Hosting e la strategia di SEO tecnica e GEO, come parte del mio lavoro in MANYA Digital.
Cosa farei diversamente: debito tecnico senza maquillage
Ho documentato questo debito in dettaglio nell'architettura del progetto, e lo ripeto qui perché mi sembra più onesto mostrarlo che nasconderlo. Ogni pagina dichiara revalidate: 60, che è semantica ISR, ma l'export statico non supporta l'ISR: quel valore non ha alcun effetto reale, il contenuto si aggiorna solo con una build manuale.
Due componenti Server (il footer e la barra di navigazione) richiedono i propri dati in modo indipendente dal resto della pagina, quindi la stessa informazione viene richiesta due volte nella stessa build. E la sitemap elenca a mano gli slug delle landing di servizio: se si crea una landing nuova su Sanity, la rotta funziona ma non compare nella sitemap finché qualcuno non la aggiunge al file.
Nessuno di questi tre punti rompe il sito oggi. Li lascio documentati perché sono esattamente il tipo di decisione che uno sviluppatore nuovo deve capire prima di toccare il codice, e perché fanno parte di come è stato davvero costruito, non di come mi piacerebbe raccontarlo.
Cosa proverei dopo
Il prossimo passo tecnico è collegare un webhook di Sanity a una GitHub Action che avvii automaticamente build e deploy quando il cliente pubblica una modifica, eliminando il passaggio manuale che oggi dipende da me. Ottimizzerei anche il caricamento delle immagini dell'hero e del portfolio per abbassare l'LCP misurato di 9,9 s, genererei la sitemap in modo dinamico a partire dalle landing reali invece di mantenere l'elenco a mano, e userei sanity typegen per generare i tipi TypeScript dallo schema reale invece di scriverli io.
Finché questo non succede, il sito continua a funzionare bene per ciò di cui QBO ha bisogno: autonomia di modifica dei contenuti, una base tecnica misurata (non solo promessa) e una configurazione pronta sia per Google sia per i motori di IA.
Fonti
Domande frequenti
Cos'è un'architettura headless?
Un'architettura headless separa la gestione dei contenuti dalla loro presentazione. In QBO Imagen, Sanity funziona come CMS e Next.js genera le pagine che ricevono i visitatori. Questo permette di gestire i contenuti da un editor indipendente dal codice del sito.
Perché Sanity e non WordPress?
Ho scelto Sanity perché avevo bisogno di modellare contenuto strutturato e mantenere separata l'interfaccia pubblica dal sistema editoriale. Anche WordPress può essere usato come CMS headless, quindi non è un limite di WordPress: è stata una decisione basata sui requisiti concreti di questo progetto.
Cosa significa export statico e perché conta per la SEO?
L'export statico genera file HTML durante la compilazione. Questo permette di consegnare il contenuto principale senza dipendere dal rendering nel browser e riduce la necessità di eseguire logica di server per ogni richiesta. Non garantisce da solo posizioni migliori su Google.
Come fa il sito a ottenere visibilità su ChatGPT, Perplexity o Google AI Overviews?
L'architettura facilita l'accesso dei crawler autorizzati al contenuto HTML, ai link, ai metadati e ai dati strutturati. Permettere la scansione non garantisce che i sistemi di IA recuperino, raccomandino o citino il sito: dipende da fattori che non controllo né ho misurato qui.
Cosa succede se Sanity si ferma durante una build?
La funzione safeFetch restituisce contenuto di riserva quando non riesce a ottenere i dati dal CMS, così la generazione di quelle sezioni può continuare. Questo non protegge da altri possibili errori della build, come uno di TypeScript o delle dipendenze.
Quanto costa mantenere un sito così?
Dipende dall'uso di Sanity, dal traffico, dallo storage, dalle build e dai servizi attivati. In questo progetto non serve mantenere un server Node proprio per servire le pagine pubbliche, ma esistono costi di hosting, CMS, dominio e manutenzione tecnica.