Por qué un directorio de 1.044 empresas no necesita un CMS: el caso MANYA Madrid
¿Un directorio de más de mil empresas necesita un CMS, o alcanza con archivos de código versionados y un build estático?
Por Pietro Fiorillo ·
Índice del artículo
El problema: ser la referencia local en un mercado de directorios pagos
El mercado estaba lleno de directorios donde paga quien aparece arriba, con reseñas poco fiables y datos desactualizados. MANYA Madrid necesitaba convertirse en la referencia local para encontrar empresas confiables en Madrid, con criterios editoriales visibles en vez de posiciones compradas sin etiquetar.
Por qué el contenido vive en código, no en un CMS
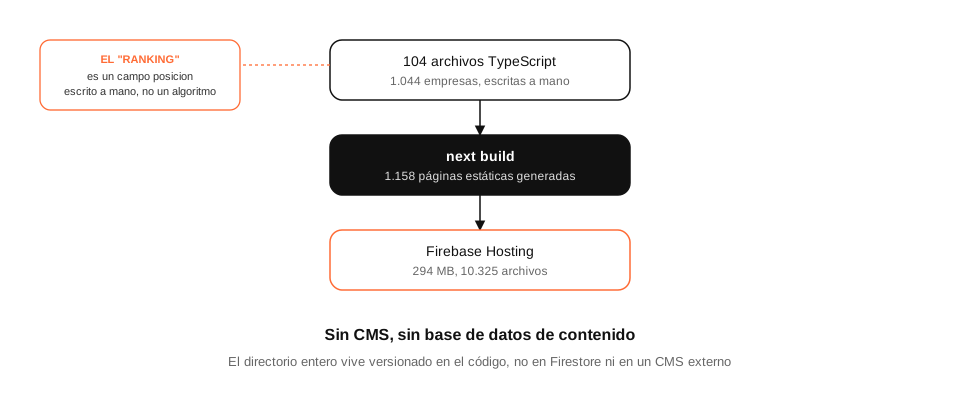
Cada empresa es un objeto Empresa definido en TypeScript, dentro de uno de 104 archivos de datos. No hay Sanity, ni Contentful, ni ningún CMS: el contenido se edita directamente en el código y se versiona con git.
export interface Empresa {
  slug: string;
  nombre: string;
  sectorSlug: string;
  barrioSlug: string;
  rating: Rating;
  descripcionEditorial: string;
  rangoPrecios: "€" | "€€" | "€€€" | "€€€€";
  premium: boolean;
  asociada?: boolean;
  ultimaVerificacion: string; // fecha ISO de la última verificación
  posicion: number; // 1-10 dentro de sector x barrio
}src/types/index.ts.El campo posicion es la clave de todo el «ranking» del directorio: un número del 1 al 10 dentro de cada combinación de sector y barrio, escrito a mano por mí, no calculado por ningún algoritmo. La «metodología de 6 fases» que describo públicamente (investigación, verificación manual, análisis de reseñas, evaluación editorial, ranking, revisión mensual) es exactamente eso: un proceso que yo sigo, no una pipeline de software. No hay ningún scraper, cron ni motor de scoring en el repositorio que la ejecute, y prefiero decirlo así de claro a dejar que suene más automatizado de lo que es.
Cómo funciona el plan premium sin pasarela de pago
El directorio tiene un plan gratuito y un plan destacado, pero no hay ningún Stripe ni integración de pago en el código. La propia página de planes lo dice: sin cobro online, el pago se formaliza por email después de verificar el negocio.
Contando los flags reales en los 1.044 registros: 10 empresas tienen premium: true hoy. Ninguna tiene asociada: true, el plan más económico, pensado para formalizarse igual por email.
Cómo validé esta arquitectura
Corrí npm run build contra el repositorio real y conté las rutas generadas en vez de repetir una cifra de memoria.
const nextConfig: NextConfig = {
  output: "export",
  images: { unoptimized: true },
};next.config.ts.| Métrica | Resultado | Entorno / evidencia |
|---|---|---|
| Lighthouse Performance (móvil, lab) | 99 / 100 | Lighthouse 13.5.0, throttling simulado |
| LCP (lab) | 1,7 s | Misma medición Lighthouse, no es un dato de campo (CrUX) |
| Tiempo de build local | 27,0 s | next build con Turbopack, Next.js 16.2.2 |
| Páginas estáticas generadas | 1.158 | 97 páginas de sector, 1.044 de empresa y el resto de rutas fijas |
| Tamaño del export | 294 MB en 10.325 archivos | Carpeta /out generada por ese build |
| Commits de desarrollo | 47, de abril a octubre de 2026 | git log del repositorio, con actividad el mismo día de este artículo |
Es, por lejos, el Lighthouse más alto que medí en toda esta serie. Mi lectura es que un directorio de texto y datos estructurados, sin un carrusel de imágenes ni lectura en tiempo real bloqueando el render inicial, deja que el export estático rinda al máximo de lo que puede dar: no hay nada compitiendo con el HTML por el primer pintado.
SEO: notificar a Google en vez de esperar a que rastree solo
El commit más reciente del repositorio, del mismo día que escribo esto, agrega un script para notificar URLs nuevas a la Indexing API de Google, en vez de depender solo de que Googlebot las encuentre por su cuenta en un directorio de más de mil páginas.
Un sistema no es más confiable por sonar más automatizado. Es más confiable cuando decís con precisión qué parte es código y qué parte es trabajo editorial.
Mi participación en este proyecto
MANYA Madrid es un proyecto propio dentro de MANYA Digital: diseñé la arquitectura, construí el sitio y llevo adelante la investigación y verificación editorial de cada empresa listada.
Lo que haría distinto: cifras publicadas que no coincidían con el código
Antes de escribir este artículo, la página del proyecto decía «67 sectores» y «más de 1.050 empresas». Contando directamente en el código (y confirmándolo con la salida del build), el número real es 97 sectores y 1.044 empresas. Ya corregí esas cifras en la página del proyecto; las dejo registradas acá como lo que fueron: una desactualización, no una exageración deliberada, pero una desactualización real de todos modos.
Qué probaría después
Evaluaría en qué punto el enfoque de «datos como código» deja de ser cómodo, probablemente cuando más de una persona necesite editar al mismo tiempo, y automatizaría una alerta simple basada en el campo ultimaVerificacion para saber qué fichas llevan más tiempo sin revisión antes de que alguien tenga que buscarlo a mano.
Fuentes
Preguntas frecuentes
¿La metodología de 6 fases es un sistema automatizado?
No. Es un proceso editorial: investigación, verificación manual, análisis de reseñas, evaluación editorial, ranking y revisión mensual. No encontré ningún scraper, cron ni motor de scoring en el código que la ejecute. Las 6 fases describen cómo trabajo yo, no una pipeline de software.
¿Cómo se decide el ranking de cada empresa?
Con un campo posicion (del 1 al 10 dentro de cada sector y barrio) escrito a mano en el archivo de datos de cada empresa. No hay un algoritmo de scoring: la posición es una decisión editorial que yo cargo directamente en el código.
¿Hay algún CMS detrás del directorio?
No. Las 1.044 empresas viven en 104 archivos TypeScript versionados en el repositorio, no en Firestore ni en un CMS externo. Firestore solo se usa para los formularios de contacto y sugerencias de cambio.
¿Por qué el Lighthouse de este proyecto es tan alto comparado con otros?
Probablemente porque es un directorio de texto y datos estructurados, sin un carrusel de imágenes pesado ni lectura en tiempo real bloqueando el renderizado inicial, a diferencia de un catálogo de productos. El export estático rinde mejor cuando hay menos contenido multimedia que cargar.
¿Cuánto cuesta mantener un directorio así?
El hosting es mínimo porque es un export estático. El costo real es el tiempo editorial: investigar, verificar y mantener actualizadas 1.044 fichas de empresa a mano, sin un CMS que automatice la carga de datos.