Cómo construí un sitio corporativo headless con Sanity y Next.js: el caso QBO Imagen
¿Se puede dar a un cliente autonomía real para editar contenido, sin servidor propio que mantener, sin perder velocidad ni visibilidad en Google y en los motores de búsqueda con IA?
Por Pietro Fiorillo ·
Índice del artículo
El problema: un estudio que no podía depender de un developer para cada cambio
QBO Imagen es un estudio de diseño gráfico, cartelería y marketing aplicado en Neuquén, Argentina. Su equipo necesitaba poder actualizar el portfolio, los servicios, los testimonios y los datos de contacto por su cuenta, sin escribirme a mí cada vez que entraba un trabajo nuevo o cambiaba un teléfono.
A eso se sumaban dos requisitos técnicos: el sitio debía cargar rápido en todo el país, porque buena parte de los clientes de QBO son remotos, y debía competir por visibilidad no solo en Google sino también en los motores de búsqueda con IA que ganaron peso durante 2026.
Por qué elegí Sanity y Next.js en vez de un CMS tradicional
Un CMS tradicional (WordPress, por ejemplo) mezcla contenido, lógica de presentación y servidor en la misma instalación. Funciona, pero cada actualización, cada plugin y cada tema son una superficie de ataque y un punto de fallo más que mantener.
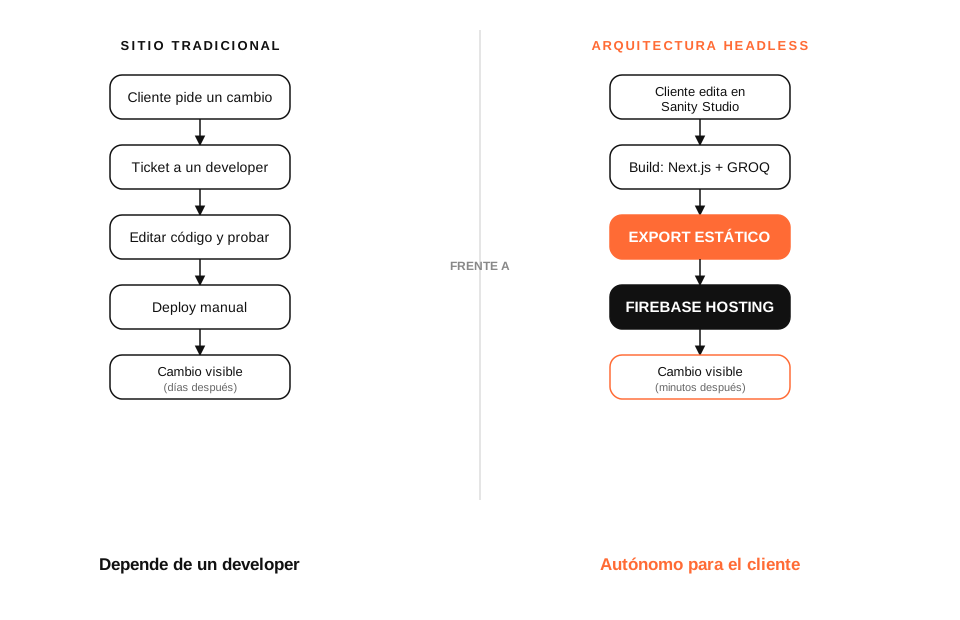
Elegí separar las dos cosas: el contenido vive en Sanity Studio, un editor visual al que QBO entra desde el navegador, y el código vive en un repositorio de Next.js que yo mantengo. Next.js consume el contenido de Sanity en build time, vía GROQ, el lenguaje de consultas de Sanity, y genera el sitio como archivos HTML, CSS y JS estáticos con output: export. Esos archivos son los que terminan en Firebase Hosting.
La consecuencia más importante: en producción no hay ningún servidor Node corriendo. El sitio que ve el visitante es HTML servido desde una CDN. No hay base de datos que atacar, no hay runtime que parchear, no hay cold start.
Cómo funciona en la práctica: del Studio a Firebase Hosting
El flujo completo tiene tres momentos distintos. El cliente edita contenido en Sanity Studio cuando quiere. El build corre cuando alguien (por ahora, yo) ejecuta npm run build: en ese momento Next.js hace fetch de seis queries GROQ en paralelo (datos del sitio, servicios, portfolio, estadísticas, testimonios y clientes) y arma cada página con esos datos. El deploy sube la carpeta /out resultante a Firebase Hosting con firebase deploy.
Entre un build y el siguiente, el sitio público no vuelve a consultar Sanity. Si QBO carga un trabajo nuevo en el portfolio al mediodía, ese trabajo no aparece en el sitio hasta que alguien corre el build siguiente. Es la parte menos automática del sistema, y la documento sin maquillarla en la sección de deuda técnica más abajo.
| Capa | Qué hace | Cuándo se actualiza |
|---|---|---|
| Sanity Studio | El cliente edita portfolio, servicios, testimonios y datos de contacto | En cualquier momento, desde el navegador |
| Build (Next.js + GROQ) | Lee el contenido de Sanity y genera HTML, CSS y JS estáticos | Cuando alguien corre npm run build |
| Firebase Hosting | Sirve los archivos estáticos desde una CDN global | En cada firebase deploy |
Cómo validé la arquitectura de QBO Imagen
Para escribir este artículo no me limité a describir la arquitectura de memoria: separé la revisión en cuatro áreas y dejé un rastro verificable de cada una. Esto corresponde al estado del proyecto documentado en octubre de 2026; las mejoras pendientes están en la última sección.
Generación estática. Corrí next build localmente (Next.js 16.2.9 con Turbopack, Node 24.11.1) e inspeccioné la carpeta /out resultante para comprobar qué contenido queda incorporado al HTML antes del deploy.
Gestión de contenidos. Revisé cómo Sanity Studio modela servicios, portfolio, testimonios y datos de contacto, y leí las queries GROQ reales que los recuperan en build time, en sanity/lib/queries.ts.
Tolerancia a fallos. Leí la implementación real de safeFetch y sus fallbacks. Hace exactamente lo que digo que hace, ni más ni menos: evita que un error al consultar Sanity rompa el build, pero no protege contra otros errores de compilación o de despliegue.
SEO técnico. Revisé los metadatos, los datos estructurados, el sitemap y el robots.txt reales del repositorio. Que estos elementos existan no demuestra por sí solo que el sitio esté indexado ni que aparezca en respuestas de sistemas de IA: eso no lo medí en esta entrega.
async function safeFetch<T>(query: string, fallback: T): Promise<T> {
  if (!isSanityConfigured) return fallback;
  try {
    return await client.fetch(query, {}, { next: { revalidate: 60 } });
  } catch {
    return fallback;
  }
}sanity/lib/queries.ts en el repositorio del proyecto, octubre de 2026.const nextConfig: NextConfig = {
...(process.env.NODE_ENV === "production" ? { output: "export" as const } : {}),
images: {
unoptimized: true,
// remotePatterns: cdn.sanity.io, img.youtube.com
},
};next.config.ts. El export estático solo se activa en producción; en desarrollo el sitio corre con el servidor normal de Next.js.Resultados medibles: lo que mide y lo que no
Medí lo siguiente el 18 de octubre de 2026, contra el hosting de producción en Firebase. Son datos de laboratorio (Lighthouse, con throttling simulado), no datos de campo de usuarios reales (CrUX), y lo dejo así de claro porque es una distinción que casi nunca se explica.
| Métrica | Resultado | Entorno / evidencia |
|---|---|---|
| Lighthouse Performance (móvil, lab) | 64 / 100 | Lighthouse 13.5.0, throttling simulado |
| LCP (lab) | 9,9 s | Misma medición Lighthouse, no es un dato de campo (CrUX) |
| CLS (lab) | 0 | Misma medición Lighthouse |
| Tiempo de build local | 28,1 s | next build con Turbopack, Next.js 16.2.9, Node 24.11.1 |
| Tamaño del export estático | 33 MB en 205 archivos | Carpeta /out generada por ese build |
| URLs indexadas en Google | No medido en esta entrega | Requiere acceso a Search Console, que no usé para este artículo |
| Tiempo de build a sitio publicado | No medido en esta entrega | Medí el build local; el paso de firebase deploy no se cronometró aquí |
El LCP de 9,9 segundos es lento, incluso para un sitio estático. La causa más probable está en el propio código: next.config.ts fuerza images.unoptimized: true, un requisito del export estático, así que el hero con carrusel y las imágenes del portfolio no pasan por ningún pipeline de optimización de imágenes. Es una mejora pendiente real, no un matiz menor, y la agrego a los próximos pasos más abajo.
El patrón fallback first: qué protege y qué no protege
Si Sanity no responde durante un build, o si falta una variable de entorno, el patrón fallback first evita que ese problema puntual rompa la generación del sitio. Cada componente que depende de contenido externo (el hero, el portfolio, los testimonios, el pie de página) tiene su propio contenido de respaldo escrito a mano dentro del componente.
La función que hace esta tarea, safeFetch, sigue siempre la misma regla: si Sanity no está configurado, devuelve el fallback sin intentar la llamada de red; si la llamada falla por cualquier motivo, atrapa el error en silencio y devuelve el mismo fallback.
Esto protege contra un problema específico: que Sanity no responda. No protege contra un error de TypeScript, una dependencia rota o un fallo del propio proceso de build. El patrón fallback first es una red de seguridad acotada, no una garantía de que el sitio nunca se rompa.
SEO no alcanza: qué controla (y qué no controla) el robots.txt
El sitio invierte en visibilidad ante dos tipos de rastreadores distintos. Para los buscadores tradicionales, hay datos estructurados Organization, WebSite y LocalBusiness, un sitemap con prioridades por tipo de página y metadatos dinámicos por landing de servicio.
Para los crawlers de IA, el robots.txt habilita explícitamente a GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Google-Extended, Applebot-Extended y otros, siguiendo el protocolo de exclusión de robots, mientras bloquea scrapers SEO agresivos como AhrefsBot o SemrushBot.
Vale la pena ser preciso con uno de esos tokens: Google-Extended no es Googlebot y no decide qué se indexa en Google Search. Según la documentación de Google, controla si el contenido rastreado puede usarse para entrenar modelos Gemini y para fundamentar respuestas con el índice de Search (grounding); no afecta la inclusión del sitio en Google Search ni actúa como señal de ranking. Habilitarlo no es lo mismo que mejorar la aparición en AI Overviews, y no hice ninguna medición que respalde esa relación.
La autonomía de contenido no es una función que se agrega al final, es una decisión de arquitectura que se toma al principio.
Mi participación en este proyecto
Para que quede claro de qué hablo cuando digo «construí»: mi participación en QBO Imagen incluyó el diseño de la arquitectura headless, la integración de Sanity CMS, el desarrollo del frontend con Next.js, la configuración del export estático, el despliegue en Firebase Hosting y la estrategia de SEO técnico y GEO, como parte de mi trabajo en MANYA Digital.
Lo que haría distinto: deuda técnica sin maquillaje
Documenté esta deuda en detalle en la arquitectura del proyecto, y la repito aquí porque me parece más honesto mostrarla que esconderla. Cada página declara revalidate: 60, que es semántica de ISR, pero el export estático no soporta ISR: ese valor no tiene ningún efecto real, el contenido solo se actualiza con un build manual.
Dos componentes Server (el pie de página y la barra de navegación) piden sus propios datos de forma independiente del resto de la página, así que la misma información se pide dos veces en el mismo build. Y el sitemap lista los slugs de las landings de servicio a mano: si se crea una landing nueva en Sanity, la ruta funciona pero no aparece en el sitemap hasta que alguien la agrega al archivo.
Ninguno de estos tres puntos rompe el sitio hoy. Los dejo documentados porque son exactamente el tipo de decisión que un desarrollador nuevo necesita entender antes de tocar el código, y porque forman parte real de cómo se construyó esto, no de cómo me gustaría contarlo.
Qué probaría después
El siguiente paso técnico es conectar un webhook de Sanity a una GitHub Action que dispare el build y el deploy automáticamente cuando el cliente publica un cambio, eliminando el paso manual que hoy depende de mí. También optimizaría la carga de imágenes del hero y el portfolio para bajar el LCP medido de 9,9 s, generaría el sitemap de forma dinámica a partir de las landings reales en vez de mantener la lista a mano, y usaría sanity typegen para que los tipos de TypeScript se generen desde el esquema real en lugar de mantenerlos escritos por mí.
Hasta que eso pase, el sitio sigue funcionando bien para lo que QBO necesita: autonomía de edición de contenido, una base técnica medida (no solo prometida) y una configuración lista tanto para Google como para los motores de IA.
Fuentes
Preguntas frecuentes
¿Qué es una arquitectura headless?
Una arquitectura headless separa la gestión de contenidos de su presentación. En QBO Imagen, Sanity funciona como CMS y Next.js genera las páginas que reciben los visitantes. Esto permite gestionar contenido desde un editor independiente del código de la web.
¿Por qué Sanity y no WordPress?
Elegí Sanity porque necesitaba modelar contenido estructurado y mantener separada la interfaz pública del sistema editorial. WordPress también puede usarse como CMS headless, así que no es una limitación de WordPress: fue una decisión basada en los requisitos concretos de este proyecto.
¿Qué significa export estático y por qué importa para el SEO?
El export estático genera archivos HTML durante la compilación. Esto permite entregar el contenido principal sin depender del renderizado en el navegador y reduce la necesidad de ejecutar lógica de servidor por cada solicitud. No garantiza por sí mismo mejores posiciones en Google.
¿Cómo logra el sitio visibilidad en ChatGPT, Perplexity o Google AI Overviews?
La arquitectura facilita que los rastreadores autorizados accedan al contenido HTML, los enlaces, los metadatos y los datos estructurados. Permitir el rastreo no garantiza que los sistemas de IA recuperen, recomienden o citen el sitio: eso depende de factores que no controlo ni medí aquí.
¿Qué pasa si Sanity se cae durante un build?
La función safeFetch devuelve contenido de respaldo cuando no puede obtener los datos del CMS, así que la generación de esas secciones puede continuar. Esto no protege contra otros errores posibles del build, como uno de TypeScript o de dependencias.
¿Cuánto cuesta mantener un sitio así?
Depende del uso de Sanity, del tráfico, del almacenamiento, de las compilaciones y de los servicios contratados. En este proyecto no hace falta mantener un servidor Node propio para servir las páginas públicas, pero existen costos de hosting, CMS, dominio y mantenimiento técnico.