Cómo construí una tienda con catálogo en tiempo real y rebuild automático: el caso Los Luises
¿Se puede tener datos en tiempo real (precio, stock) en un sitio generado estáticamente, sin perder la velocidad del export estático ni depender de una persona para republicar?
Por Pietro Fiorillo ·
Índice del artículo
El problema: un catálogo que cambia todos los días, en un sitio que se genera una sola vez
Los Luises es un taller de sublimación y estampado con más de 26 años de trayectoria. Su catálogo cambia seguido: precios, ofertas, stock y productos nuevos. El sitio, en cambio, es un export estático de Next.js: HTML generado una vez en build time, sin servidor detrás. Si cada cambio de precio necesitara un build completo, el catálogo nunca estaría al día.
Por qué separé la lectura en tiempo real del rebuild
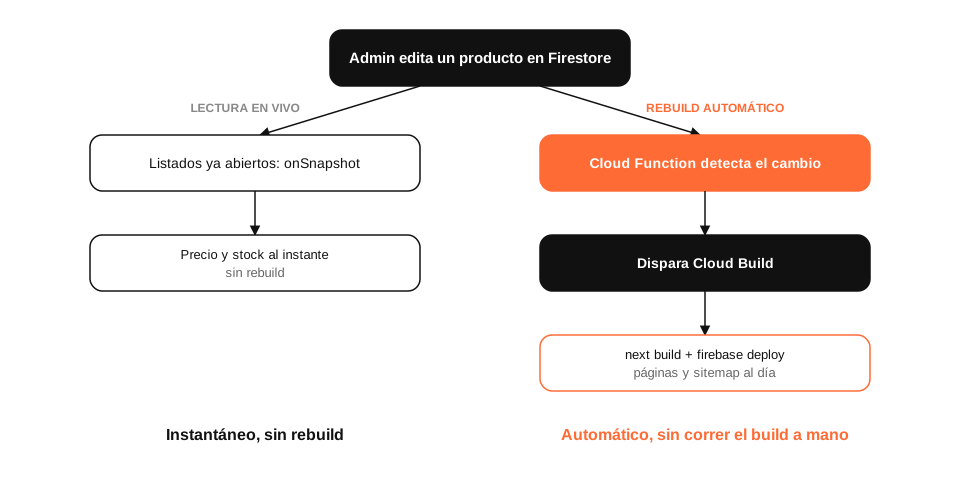
En vez de forzar todo por un solo camino, separé el problema en dos. Para datos que cambian seguido (precio, stock, ofertas), el navegador escucha Firestore directamente. Para cambios que necesitan una página nueva o afectan el sitemap (un producto nuevo, por ejemplo), el sitio se vuelve a generar completo.
El hook que hace la lectura en tiempo real es simple: se suscribe a la colección products con onSnapshot y actualiza el estado cada vez que algo cambia en Firestore, sin que el usuario recargue la página.
export function useProducts() {
  const [products, setProducts] = useState<Product[]>([]);
  const [loading, setLoading] = useState(true);
  const [error, setError] = useState<Error | null>(null);

  useEffect(() => {
    const unsubscribe = onSnapshot(
      collection(db, "products"),
      (snapshot) => {
        setProducts(snapshot.docs.map((doc) => doc.data() as Product));
        setLoading(false);
      },
      (err) => {
        setError(err);
        setLoading(false);
      }
    );
    return unsubscribe;
  }, []);

  return { products, loading, error };
}lib/useProducts.ts en el repositorio del proyecto, octubre de 2026.Cómo se dispara el rebuild solo
La otra mitad del sistema es una Cloud Function que escucha cualquier escritura en products/{productId}. Cuando detecta un cambio, llama directamente a la API de Cloud Build para arrancar un build nuevo, sin que una persona tenga que ejecutar nada.
exports.rebuildOnProductChange = onDocumentWritten(
  { document: "products/{productId}", region: "us-central1", memory: "256MiB" },
  async (event) => {
    const auth = new GoogleAuth({
      scopes: ["https://www.googleapis.com/auth/cloud-platform"],
    });
    const client = await auth.getClient();
    const projectId = await auth.getProjectId();

    const body = {
      source: { storageSource: { bucket, object } },
      steps: buildSteps(),
      timeout: "1200s",
    };

    await client.request({
      url: `https://cloudbuild.googleapis.com/v1/projects/${projectId}/builds`,
      method: "POST",
      data: body,
    });
  }
);

// Debe reflejar los mismos steps que cloudbuild.yaml en la raíz del repo.
// Si cambiás cloudbuild.yaml, actualizá esto también.functions/index.js. El comentario sobre cloudbuild.yaml está en el archivo original, no lo agregué yo.Ese comentario en el código es, literalmente, una nota que me dejé a mí mismo: los pasos del build (buildSteps()) tienen que coincidir con los de cloudbuild.yaml en la raíz del repo, y si cambio uno tengo que acordarme de cambiar el otro a mano. Vuelvo sobre esto en la sección de deuda técnica.
Cómo validé esta arquitectura
Corrí npm run build de verdad contra el repositorio (Next.js 16.2.12, Turbopack, con el .env.local real del proyecto) y medí el resultado en vez de describirlo de memoria. El build terminó en 18,8 segundos y generó 74 rutas estáticas, incluidas 54 páginas de producto (38 personalizados y 16 de stock) y un sitemap.xml con 62 URLs, que coincide con lo que devuelve el sitio en producción.
const nextConfig: NextConfig = {
  output: "export",
  images: {
    unoptimized: true,
  },
};next.config.ts. Igual que en otros proyectos, images.unoptimized es obligatorio junto al export estático.Resultados medibles
Medí lo siguiente el 18 de octubre de 2026, con Lighthouse (lab data, throttling simulado) contra el sitio en producción, y con una build real local.
| Métrica | Resultado | Entorno / evidencia |
|---|---|---|
| Lighthouse Performance (móvil, lab) | 61 / 100 | Lighthouse 13.5.0, throttling simulado |
| LCP (lab) | 18,3 s | Misma medición Lighthouse, no es un dato de campo (CrUX) |
| Tiempo de build local | 18,8 s | next build, Next.js 16.2.12, Turbopack |
| Tamaño del export estático | 24 MB en 781 archivos | Carpeta /out generada por ese build |
| Rutas estáticas generadas | 74 (54 páginas de producto) | Log del build |
| URLs en el sitemap | 62 | sitemap.xml generado por el build y confirmado en producción |
El LCP de 18,3 segundos es el más alto de todos los proyectos que medí para esta serie. Mi hipótesis, a falta de perfilar el navegador a fondo, es que se suman dos costos: images.unoptimized: true (igual que en otros proyectos con export estático) y que la lista de productos depende de que onSnapshot reciba el primer snapshot de Firestore antes de poder pintar nada. Es una hipótesis razonable a partir del código, no una causa confirmada con profiling.
Seguridad por capas: lo que permiten estas reglas y lo que no
La colección products se puede leer sin autenticación (son datos de catálogo, no sensibles) pero solo se puede escribir con sesión iniciada. Son las reglas reales del proyecto, sin resumir ni suavizar.
rules_version = '2';
service cloud.firestore {
  match /databases/{database}/documents {
    match /products/{productId} {
      allow read: if true;
      allow write: if request.auth != null;
    }
  }
}firestore.rules en el repositorio del proyecto.Esto protege contra escrituras anónimas a la base de datos. No dice nada sobre la seguridad del panel /admin en sí (login, gestión de sesión) ni sobre otras partes del sistema: es una pieza de la seguridad, no toda la seguridad.
Separar lo que cambia todo el tiempo de lo que necesita una página nueva no es una optimización, es la pregunta correcta antes de elegir la arquitectura.
Mi participación en este proyecto
Mi participación en Los Luises Sublimación incluyó el diseño completo de la arquitectura, el desarrollo full-stack (frontend, panel admin y Cloud Function), la infraestructura en Firebase y Google Cloud, y el SEO técnico, como parte de mi trabajo en MANYA Digital.
Lo que haría distinto: una advertencia que encontré en mi propio código
Revisando el repositorio para este artículo encontré dos cosas que no recordaba con precisión. La primera: los pasos del pipeline de build están escritos dos veces, una vez en la Cloud Function y otra en cloudbuild.yaml, y el propio código tiene un comentario pidiendo que se actualicen juntos. Es exactamente el tipo de duplicación que se desincroniza con el tiempo si nadie la nota.
La segunda: el runtime de la Cloud Function está fijado en Node 20, mientras que los pasos de Cloud Build corren sobre imágenes de Node 22. No rompe nada hoy, pero son dos versiones de Node conviviendo en el mismo pipeline sin que eso esté documentado en ningún lado hasta este artículo.
Ninguno de los dos puntos afecta al sitio en producción ahora mismo. Los dejo documentados porque son el tipo de detalle que vale la pena conocer antes de tocar el pipeline, no después de que algo se rompa por una actualización hecha en un solo lugar.
Qué probaría después
Unificaría la definición del pipeline en un solo archivo (que la Cloud Function lea cloudbuild.yaml en vez de duplicar sus pasos en JavaScript), alinearía la versión de Node entre la función y las imágenes de Cloud Build, y optimizaría las imágenes del catálogo para bajar el LCP medido de 18,3 segundos, probablemente el cambio con más impacto real de los tres.
Hasta entonces, el sistema cumple lo que promete: precio y stock al instante, páginas nuevas sin que nadie corra un deploy a mano, y una advertencia en el código que, ahora sí, queda escrita en un lugar donde no se va a perder.
Fuentes
Preguntas frecuentes
¿Por qué no usar simplemente ISR de Next.js en vez de Firestore en tiempo real?
Porque el sitio está exportado como estático (output: export), y ese modo no soporta ISR: ningún valor de revalidate tiene efecto real en producción. La lectura en tiempo real con onSnapshot resuelve el problema de otra forma, en el navegador, sin depender de un servidor Next.
¿Qué pasa si Cloud Build falla al reconstruir el sitio?
El sitio público sigue funcionando con la última versión desplegada; no se cae. Lo que no ocurre es que las páginas nuevas, el sitemap o los datos estructurados se actualicen hasta que una build posterior tenga éxito. No hay una alerta automática de build fallido verificada en esta entrega.
¿Es seguro que cualquiera pueda leer la colección de productos?
Las reglas de Firestore permiten lectura pública solo de la colección products y exigen autenticación para escribir. Es el mismo modelo que usaría una API pública de catálogo: los datos de producto no son sensibles, pero nadie puede modificarlos sin iniciar sesión.
¿Por qué dos sistemas (lectura en vivo y rebuild) en vez de uno solo?
Resuelven problemas distintos. onSnapshot actualiza precio y stock al instante en una página ya cargada, pero no crea páginas nuevas ni actualiza el sitemap. El rebuild hace eso, pero tarda minutos. Juntos cubren tanto la actualización inmediata como el SEO estático.
¿Cuánto tarda en verse un cambio real?
Depende de qué cambie. Un precio o el estado de stock se ve al instante en cualquier pestaña abierta. Un producto nuevo necesita que termine el build (medí 18,8 segundos en local, sin contar el deploy) antes de tener su propia página y aparecer en el sitemap.
¿Cuánto cuesta mantener una arquitectura así?
El costo depende del uso de Firestore, Cloud Functions, Cloud Build y Firebase Hosting, que tienen niveles gratuitos amplios para un catálogo de este tamaño. No hay un servidor Node propio que pagar ni mantener.